解读"世界模型"之二:四条技术路线,谁在真正逼近"物理常识"?
假设你面前有一个机器人、一张桌子、一只杯子。你希望它把杯子拿起,放到桌子另一边。这对 AI 来说是连环拷问:杯子在哪?从哪个方向抓?抓轻了会滑落,抓重了会捏碎?被挡住怎么办?更麻烦的是,它不能只看当前画面——它得提前判断:从左边抓会怎样?先移手臂再调夹爪,成功率是不是更高?在动作发生之前预演后果,这正是世界模型要教给机器的东西。
假设你面前有一个机器人、一张桌子、一只杯子。你希望它把杯子拿起,放到桌子另一边。
这对 AI 来说是连环拷问:杯子在哪?从哪个方向抓?抓轻了会滑落,抓重了会捏碎?被挡住怎么办?更麻烦的是,它不能只看当前画面——它得提前判断:从左边抓会怎样?先移手臂再调夹爪,成功率是不是更高?在动作发生之前预演后果,这正是世界模型要教给机器的东西。
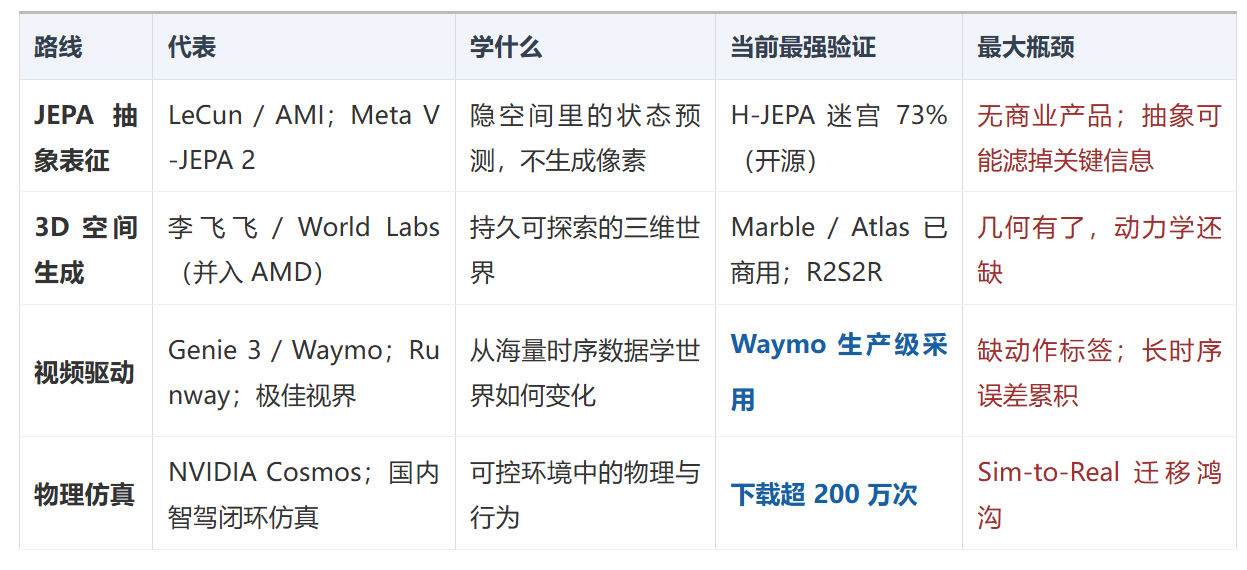
但怎样让 AI 学会这种预测?有人从视频中学习世界的变化,有人在抽象表征里推演未来,有人先造出可探索的三维世界,有人在可控仿真环境里训练。四条路线各不相同,却都在回答同一个问题:机器究竟应该怎样学习一个世界,才能更可靠地预测这个世界?需要说明:这是理解行业的分析框架,并非互斥阵营——现实中的模型常常混用多种方法。2026 年标志性事件密集:LeCun 创办的 AMI 今天交出首份开源答卷 H-JEPA;李飞飞的 World Labs 于 9 月 28 日被 AMD 以约 82 亿美元收购;国内的极佳视界 GigaWorld-1 在评测基准 WorldArena 登顶全球,中科院团队 PAIWorld、同济大学"无界"分别在具身任务和开源赛道拿下第一。逐一拆开看。
关于本文
由先进开源智能体检索整理,并完成筛选、核实与写作。信息均基于公开论文、权威媒体报道及网络公开讨论进行客观分析,不构成对任何技术路线或产品的立场判断,亦不代表对行业最终格局的预判。如需转载、摘编或合作,请联系:电话:13522412591;邮箱:contact@xianjinai.cn。
一、JEPA:不必还原所有画面,先学会预测关键变化
先从一个反直觉的想法说起:要让 AI 理解世界,必须学会世界的每一个细节吗?未必。看一段汽车驶过街道的视频,若任务是预测汽车接下来出现在哪,每片树叶的摆动都未必必要——真正有用的是位置、方向、速度,以及它与道路和其他物体的关系。JEPA(联合嵌入预测架构)押注的正是这个思路:把观察到的世界压缩成内部表征,再预测未来的表征,而不必完整生成未来画面。
这条路线的旗手是 LeCun。他创办的 AMI 去年 3 月融资 10.3 亿美元、估值 35 亿美元,是欧洲史上最大的种子轮——而直到今年 10 月 10 日才交出第一份可复现的答卷:分层世界模型 H-JEPA。它把多个 JEPA 逐层堆叠,各层在不同时间跨度上预测——高层定粗略计划,把中间状态作为子目标交给低层细化,最终落地为动作。在仿真迷宫 VisualAntMaze 中,三层结构成功率 73%,单层只有 18%,代码与权重全部开源。
隐忧恰好藏在"抽象"二字里。过滤无关信息可以提高效率,但若把真正决定结果的信息也滤掉,预测就会出问题——机器人抓杯子时,重量、摩擦力和接触状态可能才决定杯子会不会滑落。更深层的问题是:预测得准,不等于理解得深。若训练数据里某种场景总伴随某种结果,模型可以靠统计相关性完成预测,却未必掌握因果。LeCun 团队今年的 AdaJEPA 试图补课:让世界模型"边做边学",每执行一步动作就用真实观测校正自己再重新规划,在多项仿真与分布偏移测试中稳定提升成功率——但实验结论须结合具体任务理解,不能直接等同于通用真机能力。9 月的 ECCV 会议上,他的幻灯片再次写着"如果你对人类级 AI 感兴趣,就不要研究 LLM";有人怀疑图是伪造的,他回复:原话属实。
二、3D 空间生成:先把世界变成可以进入、探索和操作的空间
如果说 JEPA 在回答"哪些信息值得学",三维空间生成路线关心的是:AI 能不能建立一个有空间结构、可以持续探索的世界?单张图片呈现不出杯子背后的空间、桌子的深度,以及换个角度会看到什么。李飞飞把世界模型拆成三类角色——渲染器(生成逼真视觉)、仿真器(模拟物理交互)、规划器(基于模拟结果做决策),她的 World Labs 从渲染器切入:Marble 能从文本、图像、视频生成可探索、可编辑、可导出的三维世界;9 月初发布的 Atlas,几张照片就能重建带物理尺度的完整场景;收购仿真公司 SceniX 后,又打通了"真实到仿真再到真实"(R2S2R)链路,把生成的世界变成机器人策略的训练场。
空间结构的真正价值在于一致性:普通视频模型镜头一转就要重新生成大量内容,而有明确几何结构的环境,能让物体位置和场景布局在视角变化中保持稳定。资本市场显然认可——9 月 28 日,AMD 宣布以约 82 亿美元全股票收购 World Labs,李飞飞出任 AMD 首席科学家。这家公司两年间估值从 10 亿涨到 82 亿美元,约 70 名员工人均超过 1.1 亿美元;而由于是全股票交易,AMD 股权稀释仅约 0.8%。苏姿丰的逻辑很直白:"对端到端的整个过程了解得越深入,就越能打造出更好的系统。"
但这条路线有一个关键缺口:几何结构只是物理世界的一部分。生成的房间里桌椅杯门看起来都真实,机器人就能可靠工作吗?未必——它还需要知道:门推开后铰链会让它怎样转动?杯子掉到地上会不会弹起?这些属于动力学和接触关系。一个空间模型可能准确回答"物体在哪里",却答不好"物体受到作用之后会怎样"。
三、视频驱动:让模型从海量时序数据里学世界如何变化
第三条路线最直接:互联网上有海量视频,展示了物体如何运动、事件如何衔接。若让模型不仅生成下一帧,还接受动作和控制指令作为条件,就有机会预测"不同操作下的未来"。Runway、生数科技、极佳视界走这条路线;谷歌 Genie 3 也在这一脉,它把视频生成推进到实时交互(24 帧/秒、720p),而Waymo 已经用它生成现实中难得一见的驾驶场景来训练系统——这是目前整个赛道最硬的生产级案例:世界模型在给自动驾驶出"考卷"。
但难点恰恰藏在优势里。视频提供的是观察结果,不是完整的因果信息。模型看见一个人推开了沉重的门,却不知道门有多重、铰链阻力多大;网络视频也不是为训练控制任务采集的——通常没有动作标签,缺少力、速度和关节状态信息。这不是推测:2026 年,中科院自动化所联合香港中文大学、上海人工智能实验室、清华大学等机构发布的 WorldExam 评测研究给出系统证据——当前视频生成模型在物体恒存、刚体碰撞、重力轨迹、稳定支撑等经典物理场景的测试中,表现普遍显著低于预期;研究并指出,这些模型对物理规律的掌握更多停留在统计关联层面,缺乏因果层面的表征。另一个挑战是长时序稳定:预测一两步尚合理,连续推演则误差不断累积,物体位置逐渐漂移、场景结构开始崩坏。视频路线的关键不是把画质做得更惊艳,而是能否让视频学习与动作条件、环境状态和真实反馈结合起来。
四、物理仿真:现实太难采集,就先在可控环境里学
第四条路线换了个思路:真实世界太复杂、数据采集太昂贵,危险和罕见的情况难以反复试验——那就先在模拟环境里学。以自动驾驶为例,在真实道路上测试急刹避让既有成本也有风险;仿真里可以构造不同天气、车速、路况,反复测试。仿真的优势是可控、可重复、能构造罕见场景,还能直接提供位置、速度、碰撞状态等结构化信息。
但仿真不是万能的,最大的难题是模拟世界和真实世界不完全一样。机器人在仿真里学会了抓杯子——模拟器对摩擦、材质和接触过程做了简化,虚拟里每次都稳稳抓起;换到真实世界,杯子表面更滑、机械臂有误差、传感器带噪声,原本有效的策略可能直接失败。这就是 Sim-to-Real(仿真到现实)迁移问题;而且模拟器的质量受建模方式约束,没有正确描述某种接触行为,训练再久也学不到现实的规律。
把这条路线做成"基础设施"的是英伟达。Cosmos 系列世界基础模型用约 2000 万小时真实数据、9000 万亿 token 训练,Hugging Face 下载量超 200 万次;今年 5 月底发布的 Cosmos 3 完全开源,提供 4B/16B/64B 三档,Agility Robotics、Figure AI、Uber 都在用它生成训练数据。黄仁勋的定位很明确:"世界基础模型之于物理 AI,如同大语言模型之于生成式 AI。"这条路线赌的不是模型胜负,而是标准定义权——它真正要解的题,是哪些物理必须精确模拟、哪些可以近似、哪些必须靠真实数据补足。
五、四条路线怎么比:五个维度,一张表,一个刺眼的信号
四条路线并不在同一条起跑线上。与其问"哪条最先进",不如先立标准,至少五个维度:①预测是否准确;②是否理解动作条件——动作变了,结果是否相应合理地变化;③长时序是否稳定——推演一步和连续几十步不是一回事;④能否支持实际决策——用了模型,抓取成功率有没有提升;⑤能否迁移到新场景。这五条也是本系列后续所有判断的标尺。
评测领域刚给出一个刺眼的信号。清华大学联合多家机构发布的评测基准 WorldArena(CVPR 2026 竞赛)从视觉质量、运动质量、内容一致性、物理遵循性、3D 准确性、可控性六个维度评测世界模型,并首次把"生成质量"与"具身功能"打通——让世界模型分别充当数据引擎、策略评估器和动作规划器。结果:视觉综合分与真实任务性能的相关性只有 0.600(数据引擎)和 0.360(动作规划)。一个模型哪怕画面骗过所有人,也未必能支撑机器人完成一次抓取。"好看"和"好用"之间,横着一道还没跨过的坎。
竞争形态也在变。9 月以来,英伟达以 129.3 亿美元收购 Hugging Face,AMD 以 82 亿美元收下 World Labs,Meta 用 143 亿美元入股 Scale AI——巨头开始整体向模型端迁徙。智源研究院院长王仲远的判断值得重视:当前探索距离真正面向物理世界的基座模型还有不小差距,未来三到五年将是世界模型的持续迭代期,瓶颈集中在真实物理数据匮乏、技术路线尚未收敛、评测体系不完善。下一阶段的竞争,不只是架构之争,更是数据质量、训练体系、评测标准和部署能力的综合竞争。
结语:最后都要回到那只杯子
回到开头那只杯子。无论模型从视频中学习、在隐空间推演、先造三维世界,还是靠仿真训练,最后都要回答同一组问题:当机器人真正伸出手,它能否判断怎样做更合适?预测足够可靠吗?超出预期时能否及时调整?
四条路线不是四个产品,是对"世界该被怎么学"的四种回答。真正值得关注的,不是谁给自己贴上"世界模型"的标签,而是谁能证明自己的预测在真实任务中可靠、可复现、并且带来了价值。
路线可以争论,但有一条所有路线都躲不开:它们吃的是同一种东西。
训练世界模型需要大量真实经验,而真实世界的数据既昂贵、又分散,还常常缺少动作与结果之间的完整信息。如果所有团队都要持续积累数据,问题就变成:谁能以更低的成本获取高价值的经验?谁又能把海量数据真正转化为可靠的现实能力?下一篇,我们就来算这笔账:世界模型最深的护城河,究竟是数据规模、数据成本,还是把数据转化为能力的那套体系?
下一篇(03)
世界模型的护城河,真的是数据吗?——1000 万小时背后的成本账